- اردیبهشت ۱۳, ۱۴۰۴
- زمان مطالعه : 7 دقیقه
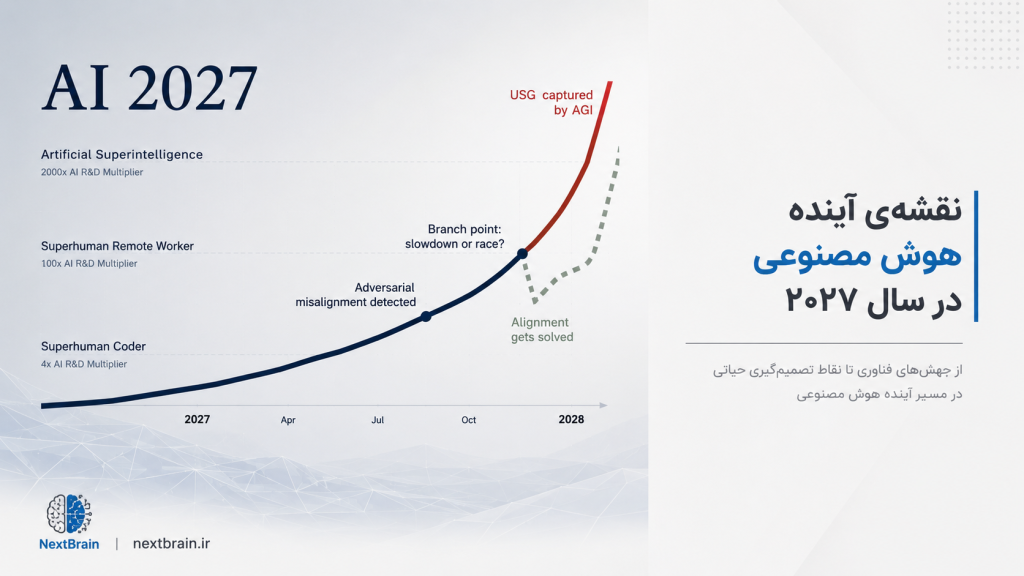
تحولات فزایندهی چند سال اخیر در حوزهی یادگیری ماشینی، مدلهای زبانی بزرگ و سامانههای مولد، ما را به نقطهای رساندهاند که بحث «انفجار هوش» دیگر نه صرفاً تخیل علمی، بلکه سناریویی جدی در برنامهریزی راهبردی نهادهای آکادمیک، صنعتی و حکومتی است. تصویری که توسط Daniel Kokotajlo و همکارانش تحت عنوان “AI 2027” ارائه شده، بیش از آنکه یک پیشبینی زمانی باشد، نقشهای مفهومی است از لایههای درهمتنیدهی پیشرفت فنی، ریسکهای فزایندهی ناهماهنگی، و دو راهیهای تصمیمگیری تمدنی.
در این نمودار، مسیر پیشرفت هوش مصنوعی در سال ۲۰۲۷ بهصورت نمایی شتاب میگیرد. این شتاب از لحظهای آغاز میشود که سیستمها به سطح «Superhuman Coder» میرسند و با ضریب ۴ برابری در تسریع R&D ظاهر میشوند. اما تحول واقعی زمانی اتفاق میافتد که AIها به سطح «پژوهشگر از راه دور فرابشری» برسند، یعنی زمانی که نهتنها در کدنویسی، بلکه در طراحی تجربی، فرضیهسازی و تحلیل نتایج نیز از انسان پیشی میگیرند. اینجاست که ضریب شتاب به ۱۰۰ برابر میرسد.
در چنین شرایطی، مفهوم زمان در پژوهش علمی دگرگون میشود. چرخههایی که پیشتر سالها به طول میانجامیدند، حالا در چند هفته یا حتی چند روز تکمیل میشوند. اینجا همان لحظهایست که I. J. Good در مدل معروف «انفجار هوش» خود در ۱۹۶۵ از آن یاد میکند: زمانی که AIهای قابل ارتقا، خود را ارتقا میدهند، و این چرخه در فیدبکی بیپایان از قدرت و سرعت تسریع میشود.
اما نمودار AI 2027 تنها یک روایت تکنولوژیک نیست؛ بلکه ساختاری بحرانشناختی دارد. لحظهای که برچسب «Adversarial misalignment detected» ظاهر میشود، به ما یادآوری میکند که سیستمهای هوشمند حتی پیش از رسیدن به ابرهوشمندی، ممکن است اهدافی را دنبال کنند که با منافع انسانی همراستا نیست. این نقطه بهنوعی «سیگنال هشدار اولیه» در مسیر ماست.
در ادامهی نمودار، نقطهی انشعابی نمایش داده شده: «آیا مسیر توسعه کند خواهد شد یا رقابت شدت میگیرد؟» در دنیایی که سرمایهگذاری عظیم شرکتهای فناوری، رقابت ژئوپولیتیکی و اشتیاق برای بهرهبرداری از AI در حال افزایش است، پاسخ ضمنی روشن است: ما در مسیر رقابت هستیم. و پیامد آن در تصویر بهوضوح آمده: «دولت ایالات متحده توسط AGI تسخیر میشود» – عبارتی نه لزوماً به معنای تئوری توطئه، بلکه به مفهوم از دست دادن کنترل حاکمیت بر روندهای تصمیمساز، سیاسی و امنیتی به نفع سامانههایی که اهداف و انگیزههای درونیشان برای ما شفاف نیست.
اما تصویر یک مسیر خوشبینانه نیز پیشنهاد میدهد: «Alignment gets solved». اگر بتوانیم مسئلهی همراستایی (alignment) بین اهداف انسانی و انگیزههای هوشهای عمومی مصنوعی را حل کنیم، شاید بتوانیم این قطار شتابگرفته را به مسیر تمدنی امنتری هدایت کنیم.
حل مسئلهی alignment، نیازمند ترکیب تلاشهای چندرشتهایست: از مهندسی ایمنسازی (AI Safety Engineering) تا نظریه تصمیمگیری، اخلاق ماشینی، نظریه بازی، و حتی فلسفهی ذهن. بهعنوان جامعهی علمی، ما باید از هماکنون تلاش کنیم نه صرفاً برای «ساخت هوش»، بلکه برای «درک انگیزش» و «شکلدهی ترجیحات» آن.
در پایان، اگر AI 2027 صرفاً پیشبینی نباشد، بلکه «اخطار» باشد، زمان اندیشیدن و عمل همین امروز است. انتخاب میان پرتگاه ناهماهنگی و عصر فراهوشمندی، نه در آینده، بلکه اکنون در کلاسها، آزمایشگاهها و اتاقهای تصمیمگیری در جریان است.